Terbit
Cara Google Menemukan Website-mu: Crawl, Render, dan Index
Sebelum muncul di Google, halamanmu harus di-crawl, dirender, lalu diindeks. Ini penjelasan tiap tahap, masalah yang sering terjadi, dan cara mengeceknya.
Kamu sudah capek-capek bikin website, tulis konten, pasang foto produk. Tapi pas dicari di Google, halamannya nggak muncul sama sekali. Sering kali masalahnya bukan di kontennya, tapi di tahap yang lebih awal: Google belum berhasil menemukan, membaca, atau menyimpan halaman itu.
Di artikel ini aku jelasin tiga tahap yang dilewati setiap halaman sebelum bisa tampil di hasil pencarian, masalah yang paling sering bikin gagal, dan cara mengeceknya sendiri. Biar gampang, aku ditemani Crawly, maskot web crawler di situs ini.
Tiga tahap sebelum halaman bisa muncul di Google
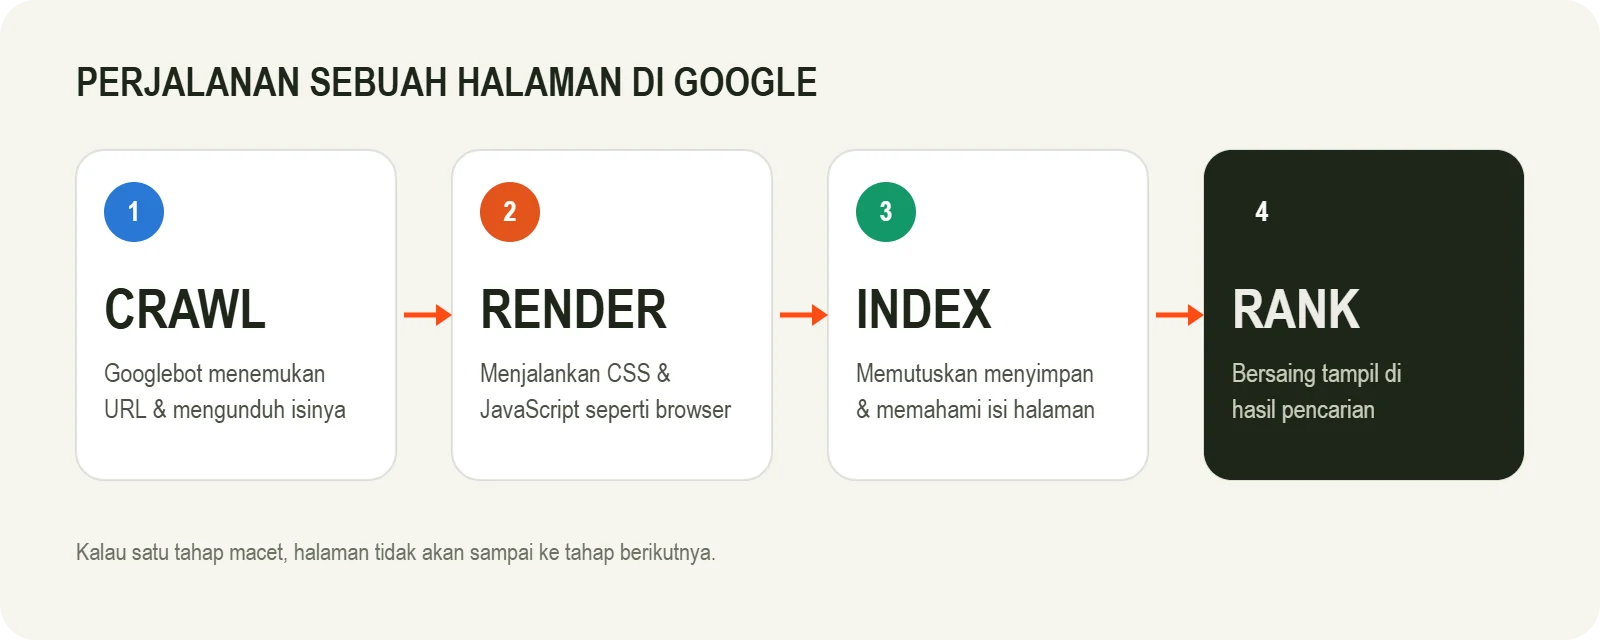
Secara sederhana, perjalanan sebuah halaman di Google kira-kira begini:
- Crawl. Googlebot menemukan URL halamanmu lalu mengunduh isinya.
- Render. Google menjalankan halaman itu seperti browser, termasuk CSS dan JavaScript, supaya tahu tampilan dan isi akhirnya.
- Index. Google memutuskan apakah halaman itu layak disimpan di indeksnya, lalu mencatat isinya.
Baru setelah ketiganya lewat, halamanmu ikut bersaing di tahap keempat: ranking. Kalau satu tahap saja macet, halaman itu nggak akan pernah sampai ke hasil pencarian, sebagus apa pun isinya.
1. Crawl: Googlebot menemukan dan mengunduh halaman
Googlebot menemukan URL baru dari beberapa sumber:
- Link dari halaman lain, baik dari situsmu sendiri maupun situs orang lain.
- Sitemap XML yang kamu kirim lewat Google Search Console.
- URL yang sudah dikenal sebelumnya, yang dicek ulang secara berkala.
Sebelum masuk, Googlebot selalu membaca file robots.txt di root domainmu. File ini berisi aturan bagian mana yang boleh dan tidak boleh di-crawl.
Satu hal yang sering disalahpahami: Disallow di robots.txt melarang crawl, bukan melarang index. Kalau halaman yang diblokir punya banyak link masuk, URL-nya tetap bisa muncul di Google, hanya saja tanpa deskripsi karena Google nggak boleh membacanya. Untuk benar-benar mengeluarkan halaman dari hasil pencarian, pakai noindex, dan jangan blokir halaman itu di robots.txt supaya tag noindex-nya bisa terbaca.
Yang sering bikin crawl gagal
- robots.txt terlalu ketat, misalnya memblokir seluruh situs (
Disallow: /) yang lupa dihapus setelah website selesai dibuat, atau memblokir folder CSS dan JavaScript. - Server error (5xx) atau timeout. Kalau server sering gagal merespons, Googlebot akan memperlambat crawl.
- Rantai redirect yang panjang, misalnya
http→https→www→ halaman baru. - Halaman yatim (orphan page), yaitu halaman yang tidak ditautkan dari halaman mana pun di situsmu.
- URL tak terbatas dari filter, sorting, atau parameter, sehingga Googlebot sibuk meng-crawl variasi URL yang isinya sama.
Cara mengecek
Di Google Search Console, ada tiga alat yang paling berguna:
- URL Inspection: masukkan satu URL untuk melihat apakah Google bisa meng-crawl dan mengindeksnya.
- Crawl stats (menu Settings): grafik permintaan Googlebot ke situsmu, termasuk status respons dan waktu responsnya.
- robots.txt report (menu Settings): versi robots.txt yang dibaca Google dan apakah ada error.
2. Render: Google menjalankan halamanmu seperti browser
Setelah diunduh, halaman dirender oleh Google memakai versi Chromium yang selalu diperbarui. Di tahap ini JavaScript dijalankan, jadi konten yang dimunculkan lewat JavaScript tetap bisa dibaca. Masalahnya, rendering bisa terjadi belakangan, dan kalau file JavaScript atau CSS-nya diblokir atau error, hasil render Google bisa berbeda dengan yang dilihat pengunjung.
Supaya aman, letakkan konten penting dan link navigasi langsung di HTML. Contoh paling umum adalah link yang tidak bisa diikuti Googlebot:
<!-- Bisa diikuti Googlebot -->
<a href="/harga/">Lihat harga</a>

<!-- Tidak bisa: tidak ada href -->
<span onclick="go('/harga/')">Lihat harga</span>
Googlebot hanya mengikuti link yang punya atribut href. Tombol atau elemen yang pindah halaman lewat JavaScript saja tidak dihitung sebagai link.
Cara mengeceknya: buka URL Inspection, klik Test live URL, lalu lihat screenshot dan HTML hasil render. Kalau ada bagian yang hilang di sana, berarti Google juga tidak melihatnya.
3. Index: Google memutuskan menyimpan halaman atau tidak
Halaman yang berhasil di-crawl dan dirender belum tentu masuk indeks. Google menilai dulu apakah halaman itu boleh, layak, dan unik untuk disimpan. Beberapa hal yang menentukan:
- Tag
noindexdi meta robots atau di headerX-Robots-Tagmembuat halaman dikeluarkan dari indeks. - Canonical memberi tahu versi mana yang utama kalau ada beberapa URL dengan isi yang sama atau mirip.
- Konten duplikat atau tipis sering dianggap tidak perlu disimpan.
- Soft 404, yaitu halaman kosong atau "produk tidak ditemukan" yang tetap membalas status 200.
Laporan Pages di Search Console menunjukkan alasan halaman tidak terindeks. Ini status yang paling sering muncul dan artinya:
| Status di Search Console | Artinya | Yang bisa dilakukan |
|---|---|---|
| Discovered – currently not indexed | Google sudah tahu URL-nya, tapi belum sempat meng-crawl | Perkuat internal link ke halaman itu, pastikan server cepat |
| Crawled – currently not indexed | Sudah di-crawl, tapi Google memilih belum menyimpannya | Perkaya isi halaman, hindari halaman tipis atau mirip satu sama lain |
| Excluded by 'noindex' tag | Ada tag noindex di halaman | Hapus tag-nya kalau halaman ini memang ingin muncul |
| Duplicate without user-selected canonical | Ada halaman lain yang isinya sama, dan kamu belum menentukan versi utama | Pasang canonical ke versi yang benar |
| Blocked by robots.txt | Googlebot dilarang meng-crawl halaman ini | Periksa aturan Disallow di robots.txt |
Checklist cepat
Kalau halamanmu belum muncul di Google, cek urutan ini dulu sebelum mengutak-atik konten:
- Buka
domainmu.com/robots.txtdan pastikan tidak adaDisallow: /atau aturan yang memblokir halaman penting. - Pastikan sitemap XML ada dan sudah dikirim di Search Console.
- Cek halaman dengan URL Inspection: apakah bisa di-crawl dan statusnya apa.
- Pastikan halaman membalas status 200, bukan redirect berantai atau error.
- Cari tag
noindexyang tidak sengaja terpasang, terutama setelah migrasi atau pindah tema. - Pastikan canonical menunjuk ke URL halaman itu sendiri, atau ke versi yang memang utama.
- Tautkan halaman dari halaman lain yang relevan, misalnya dari menu, kategori, atau artikel terkait.
- Lihat hasil render di Test live URL untuk memastikan konten utama dan link-nya terbaca.
Halaman yang tidak bisa di-crawl tidak akan pernah diindeks, sebagus apa pun isinya.
Setelah terindeks, baru soal ranking
Kalau ketiga tahap tadi sudah lancar, barulah kualitas konten, relevansi dengan pencarian, kecepatan halaman, dan link dari situs lain berperan menentukan posisi halamanmu. Penjelasan interaktif soal tahap-tahap ini, termasuk bagaimana mesin jawaban AI mengutip website, bisa kamu lihat di halaman Apa itu SEO?.
Mau tahu apakah situsmu punya masalah crawl atau index? Coba audit SEO gratis di situs ini. Crawly akan memeriksa robots.txt, sitemap, status halaman, canonical, dan noindex dalam beberapa detik.